最近関心のあるトピックについて話そうと思う。以前に書いた記事 Crit でのセルフコードレビュー開発サイクルで紹介したが、ソースコードや HTML、Markdown に対して GitHub ライクなコードレビュー UI をローカルで立ち上げるツールの Crit を使っている。これは LLM エージェントとシームレスに差分についてやり取りでき、GitHub でのレビュワーとレビュイーのように、指示したり反応したりできる。
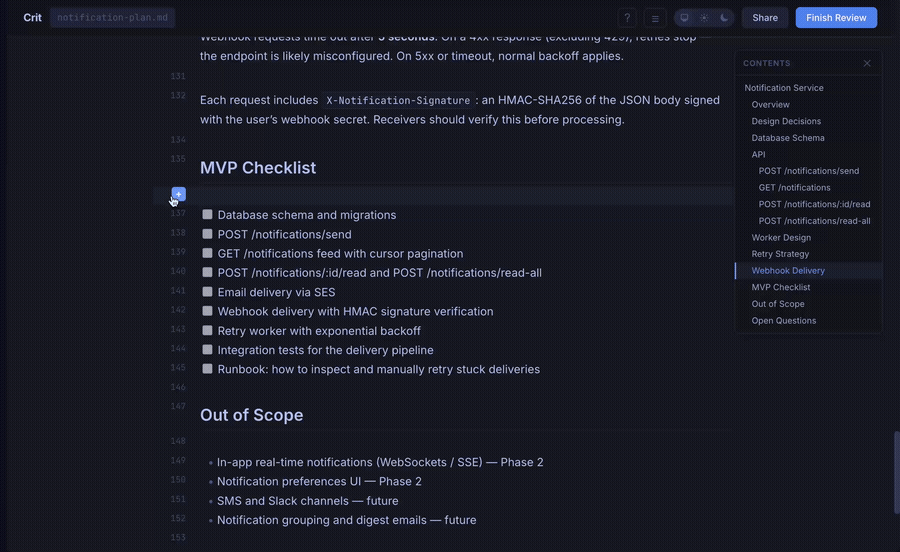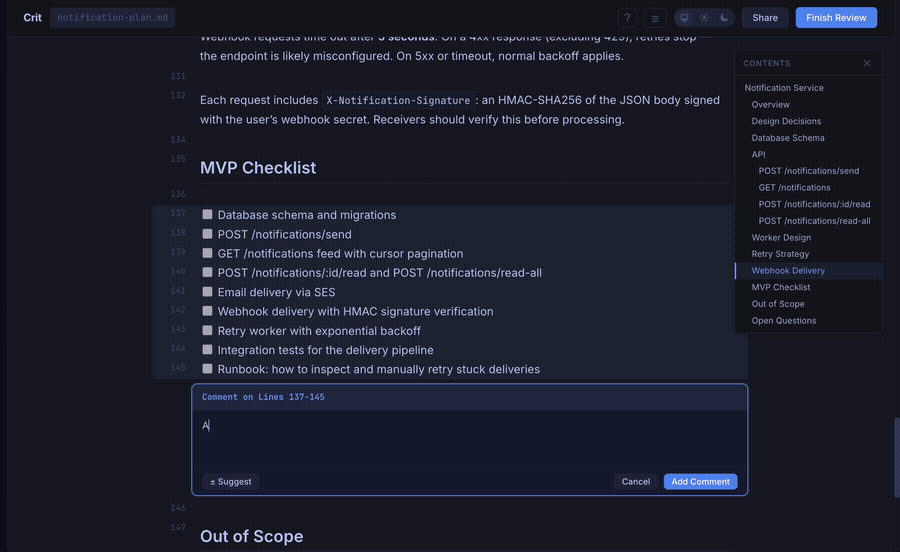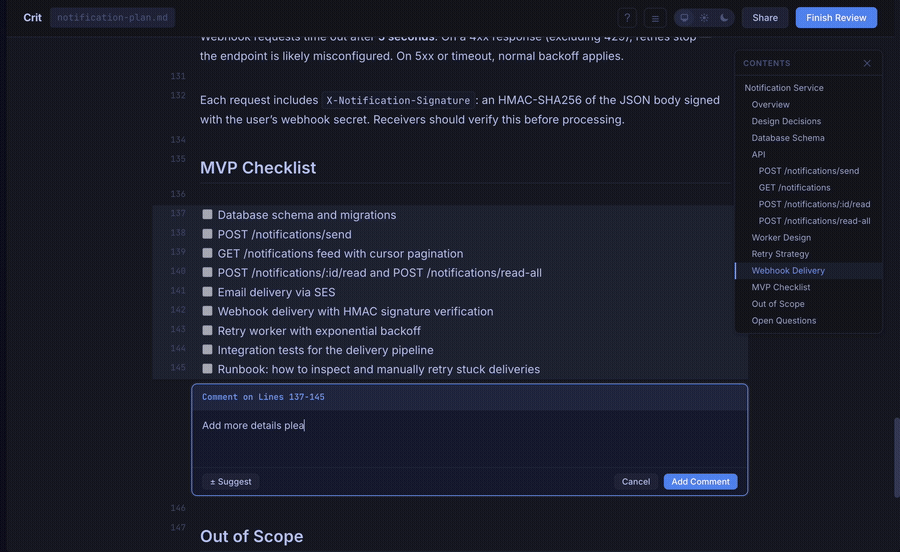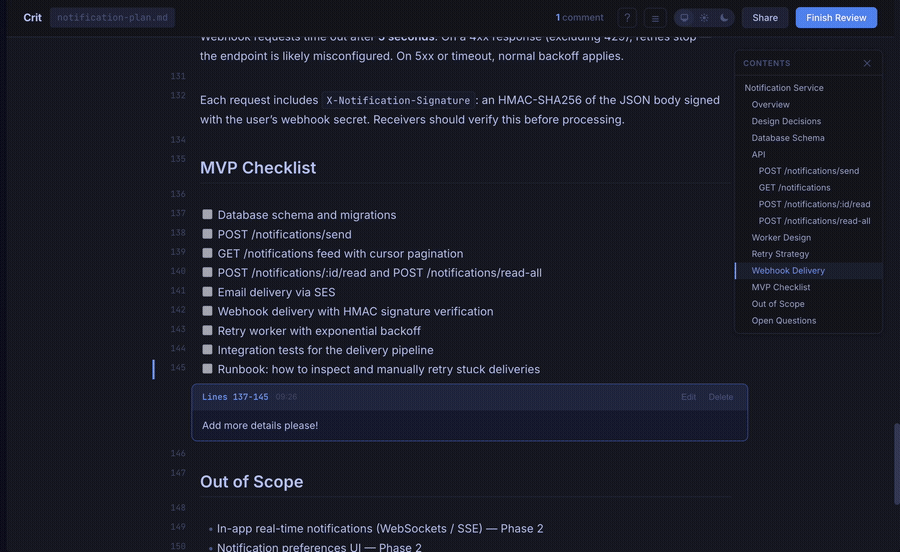
Claude Code のデスクトップアプリをはじめ、差分に対して指示を出せるツールはいくつかある。ただ、ほとんどは一方向で、Crit のようにインラインコメントの形で LLM エージェントから返答が返るような体験としてデザインされていない。認知負債、理解負債という言葉を聞くことが増えたが、対象を正しく理解するという行為は難しい。わかっていない状態に、わかっていないことが上乗せされると、考えることを放棄してしまう力学が働く。一方向に指示するだけのツールデザインはこれを助長するように思えて、頭の悪い自分には合わない。
巷では、コードレビューをせずに多くの PR をマージする、といった事例を聞くことが増えた。前提として Pull Request の数が増えること自体に価値があるわけではないのと、リスク許容度によるグラデーションがあるので、このトピックで会話する相手は選びたい。趣味の開発でこそ私も似たようなことをしているが、仕事で同じようにはやれていない。リスク許容度の低い金融というドメインで賃金を得ている以上、少なくとも現段階では、(ハーネスを用意した上で)人間の認知リソースを使ったコードレビューを、自分のコードにも他人のコードにも課している。
さて、最近は自分の理解がボトルネックにならないよう手を打っていて、その一つとして Crit を改造し、Language Server の機能をせこせこと足している。Crit には --pr オプションがあり、GitHub の Pull Request などリモートの差分に対して Crit を動かせる。このリモートの差分の上で、ホバーでの型情報の表示や、定義ジャンプ・参照ジャンプができるようにした。定義ジャンプ先はポップアップ(VS Code の Peek Definition のようなもの)で表示し、その中でさらにジャンプもできる。
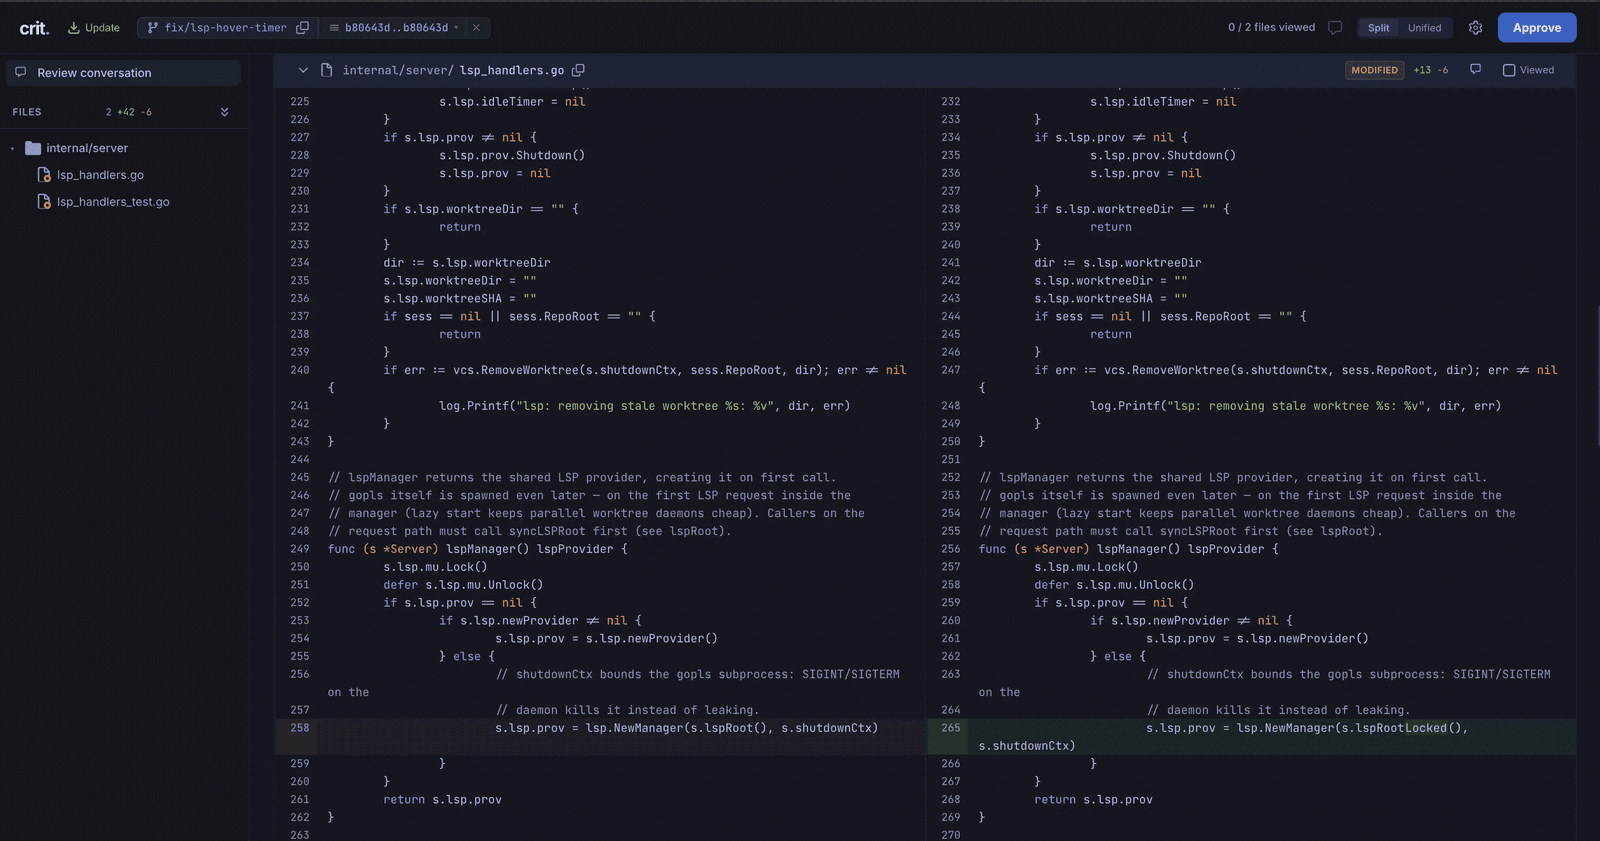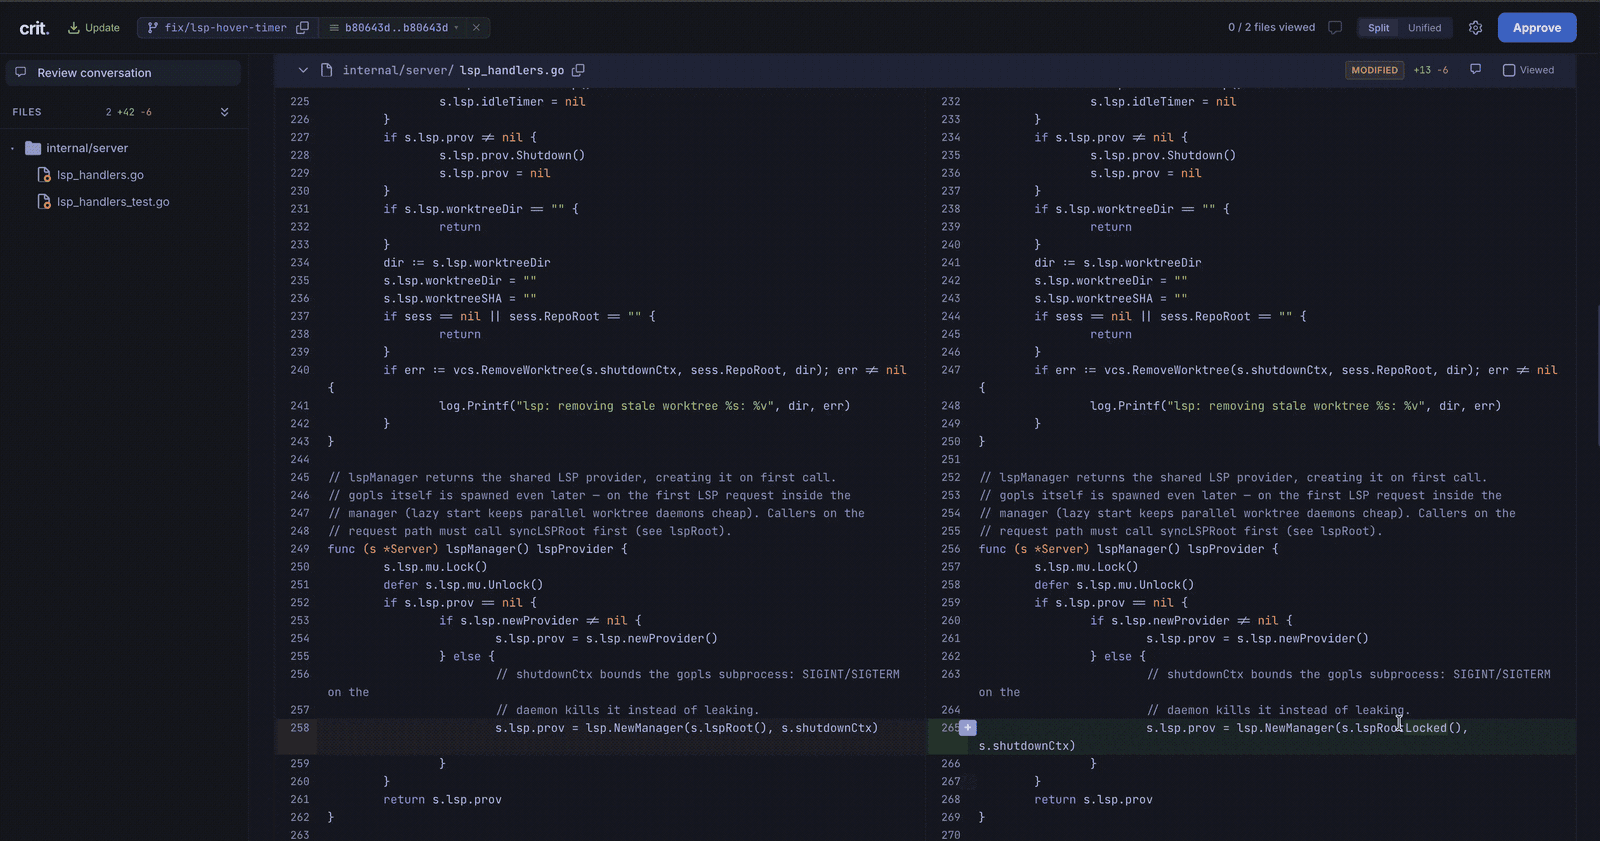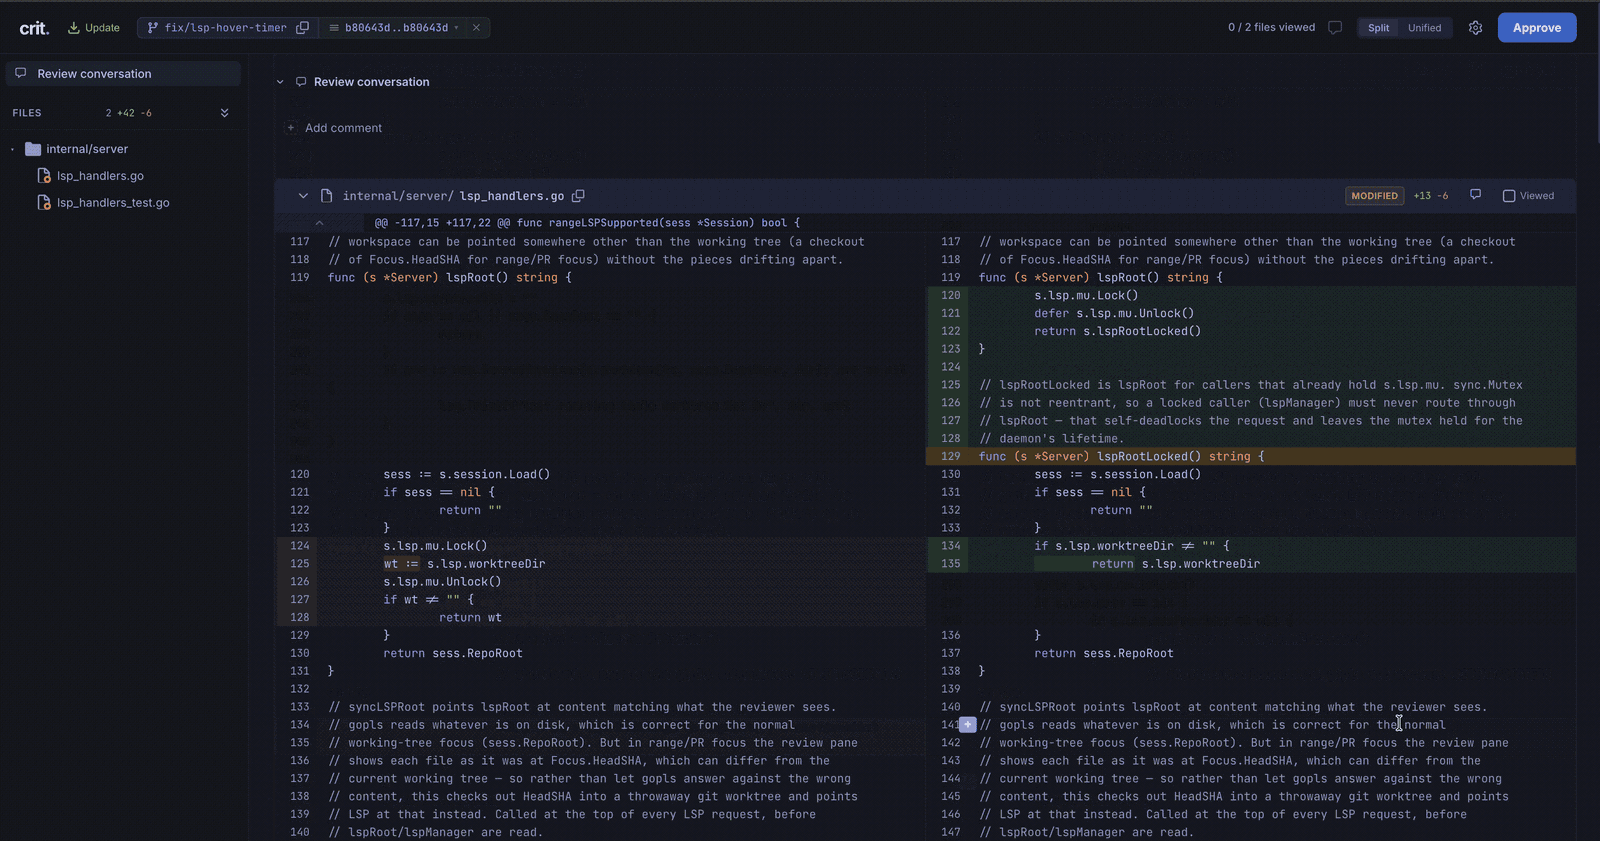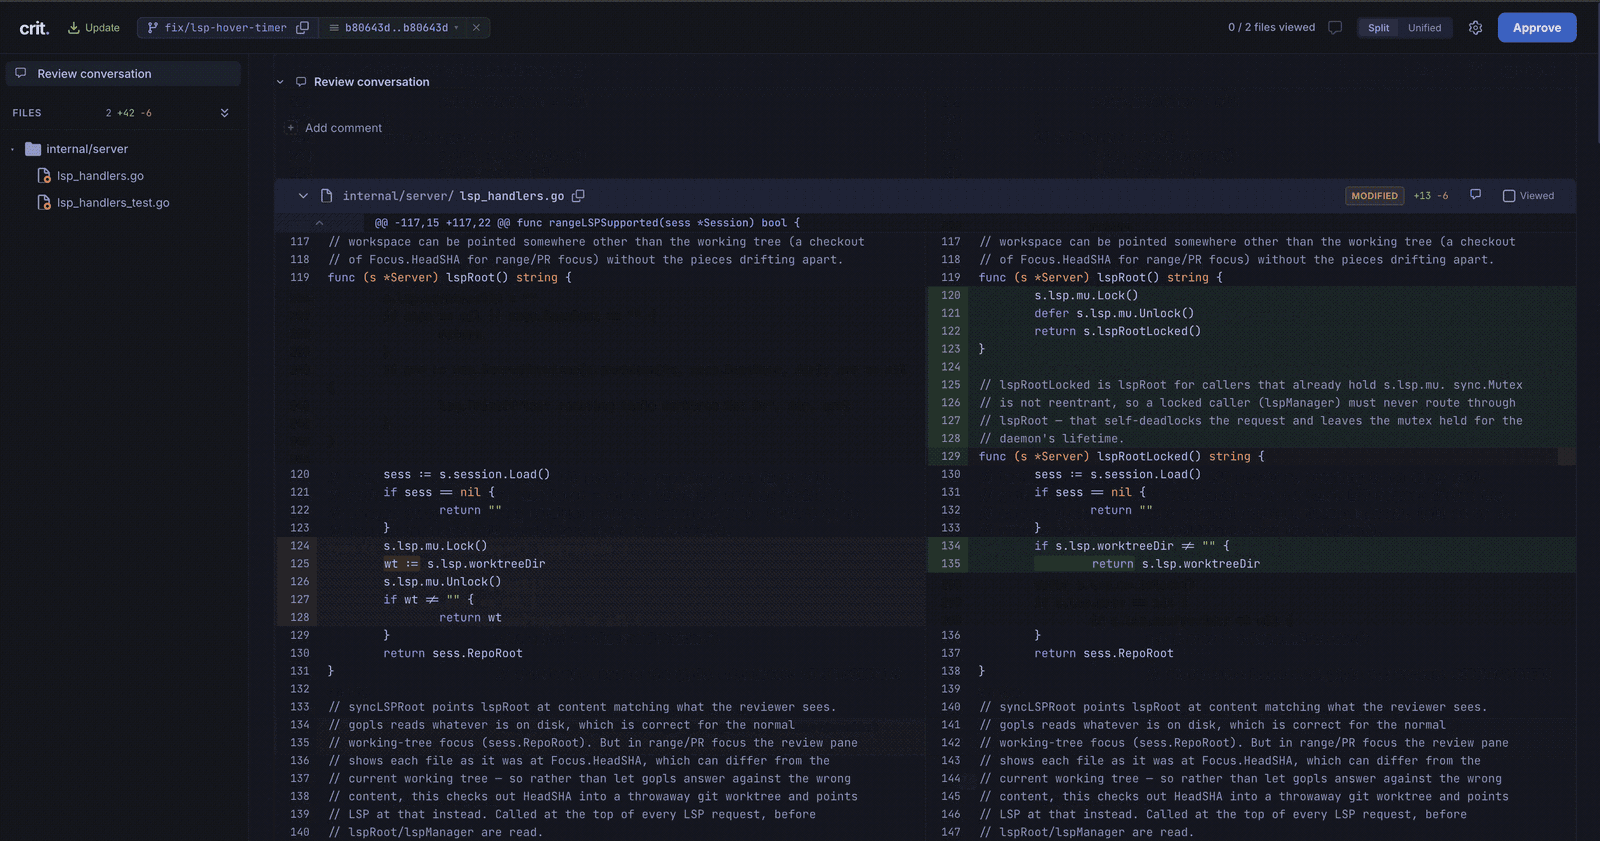
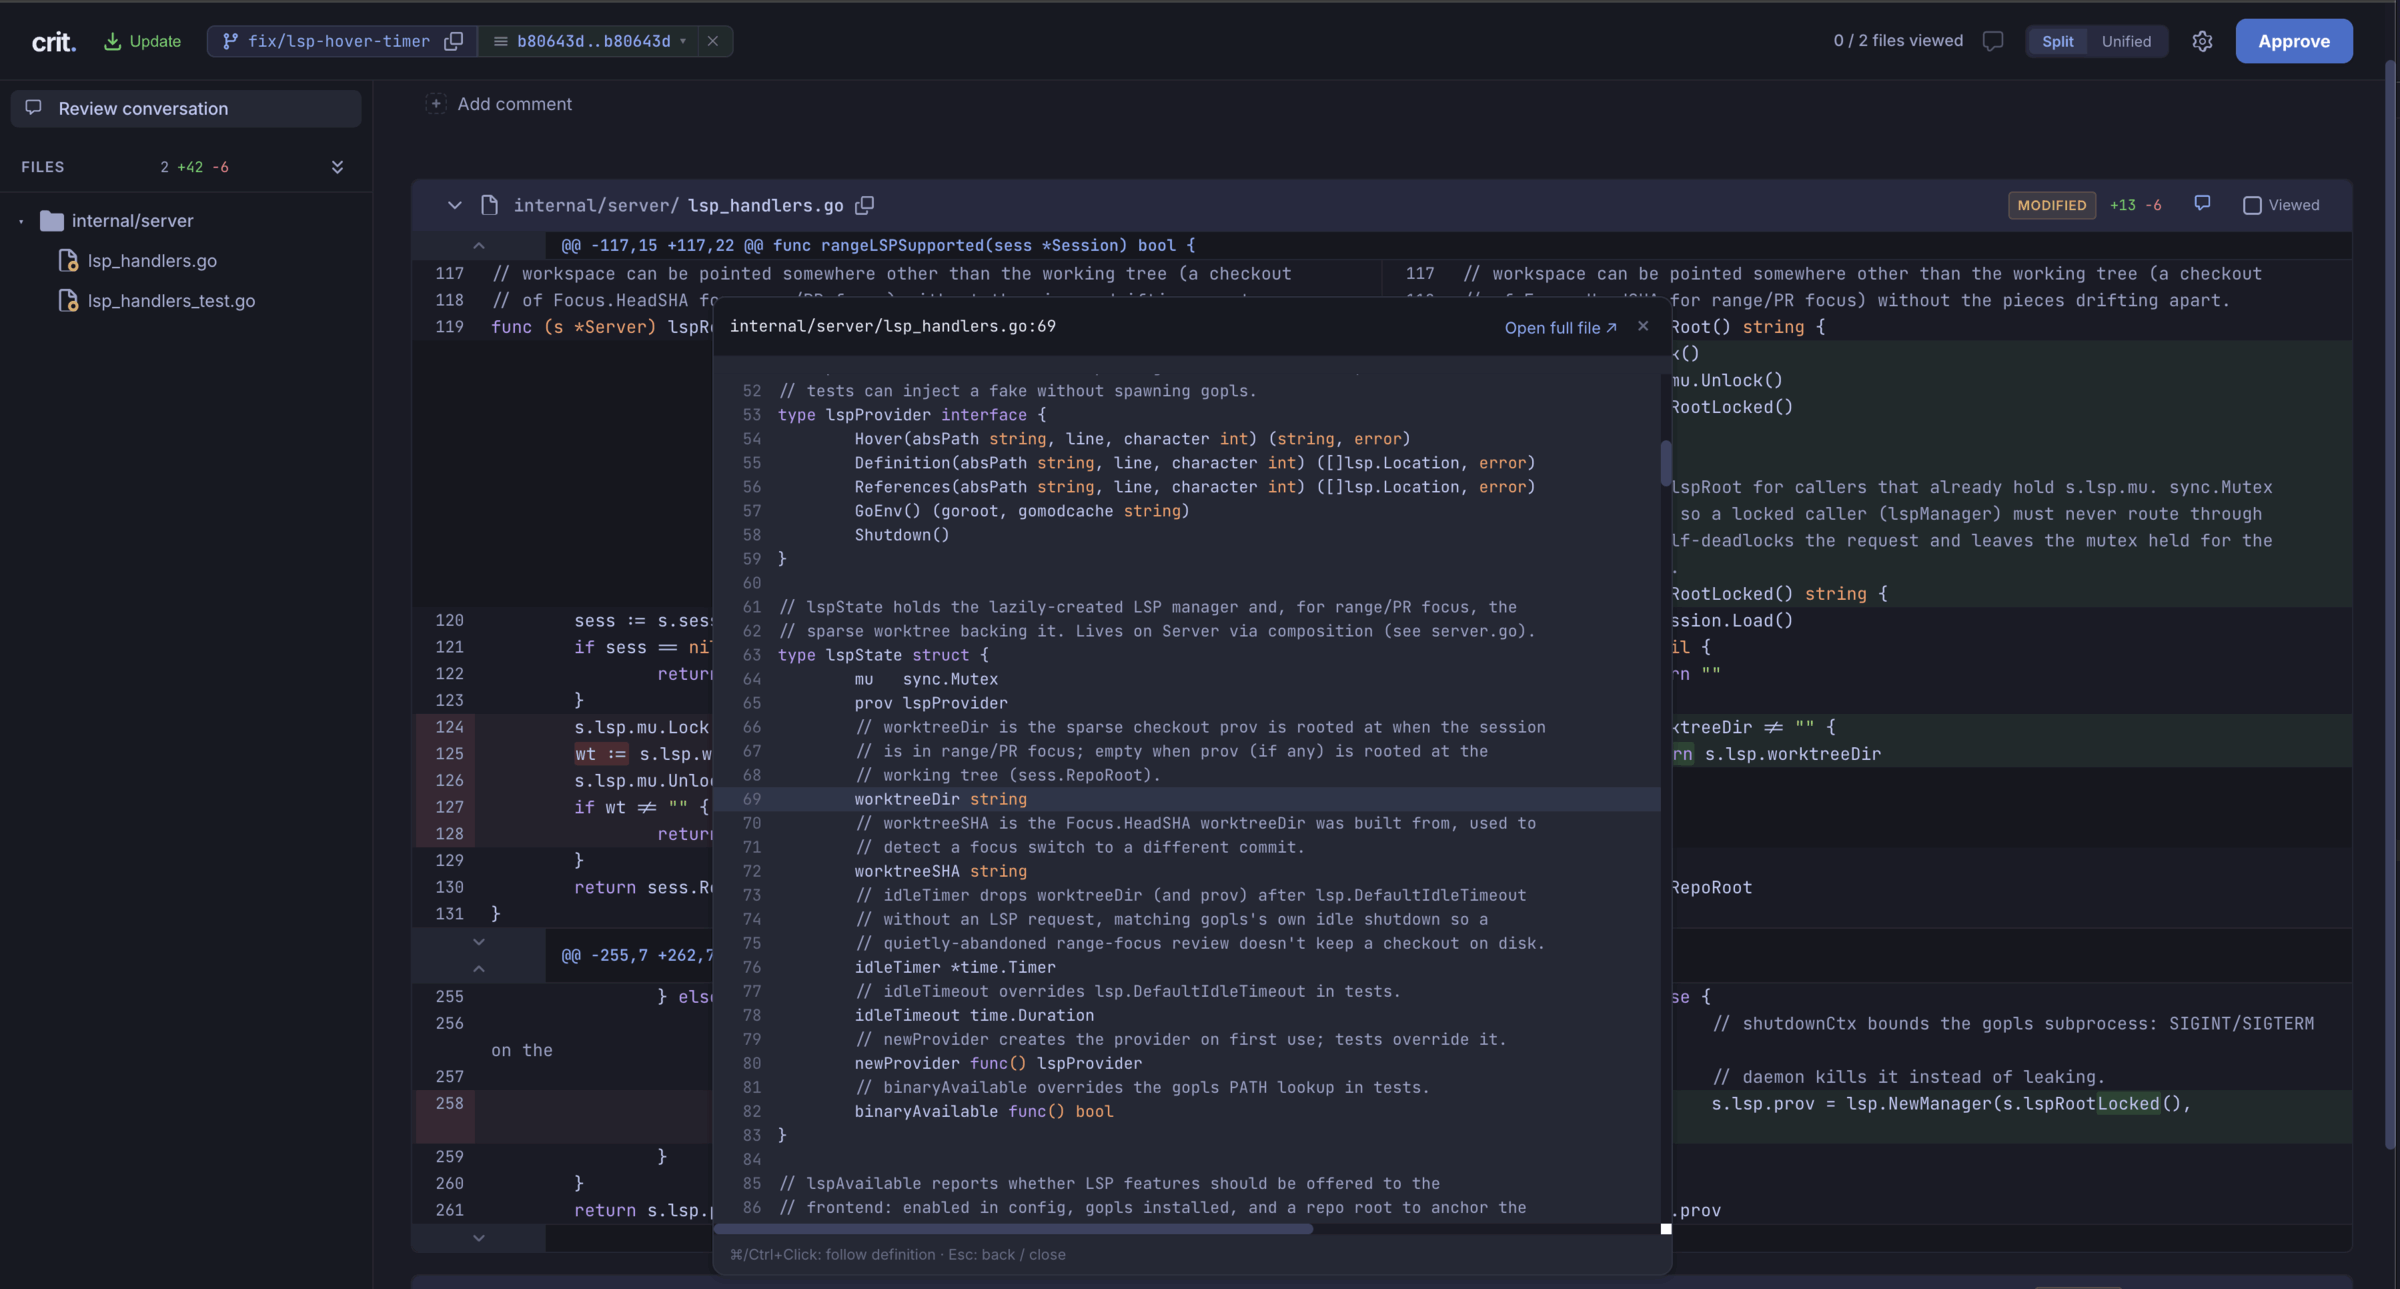
このような、リモートの pull request の差分でLanguage Serverを動かす機能を実現するには、LLM にエイヤと雑に投げるだけでは片付かない課題がいくつかある。まだ実装していないものもあるが、整理も兼ねて紹介してみよう。
課題
- ローカルとリモートのコードベースのズレが発生する
- Language Server の解析時に、悪意のあるコードを実行してしまうかもしれない
- Reference (参照ジャンプ) のメモリ利用が多い
以下は Go(gopls)での話。
1. ローカルとリモートのズレが発生する
crit --pr は作業ツリーを切り替えない。PR の head のコミットを fetch するだけで、画面に出す内容は git show <HeadSHA>:<path> で取り出している。レビューのために作業中の変更を stash させられるツールは使いたくないので、これは意図した設計だ。
ところが Language Server はディスク、つまり手元の作業ツリーを読む。画面には PR の内容が出ているのに、gopls が見ているのは自分のブランチの内容になる。リモートではシグネチャが変わっていたり、そもそも存在しなかったりする関数に飛んだり、ホバーに古い型情報が出たりする。

画面が参照する内容(HeadSHA)と gopls が解析する内容(ディスク)の出所が食い違っているのが原因だ。
変更ファイルだけ差し替える案はダメ
LSP には、ディスクではなくクライアントが持っている内容をサーバーに渡す仕組みがある(textDocument/didOpen)。PR で変更されたファイルだけ PR の内容を送りつければいいのでは、と最初は考えた。
これは筋が悪い。定義ジャンプの行き先は、たいてい PR の差分に入っていないファイルだからだ。Language Server の中で「変更ファイルは PR の内容、それ以外は手元の内容」という状態が混ざり、こんなことが起きる。
- 変更ファイル内にジャンプすると、gopls は PR 基準の行番号を返す。ところがポップアップはディスクのファイルから切り出すので、別の関数が表示される
- PR の外のファイルにジャンプすると、ジャンプ元は PR 基準、ジャンプ先は手元基準になる。リネームが絡むと解決に失敗する
- 参照ジャンプの結果に、PR 基準と手元基準の行番号が混ざる
他のサービスはどうしているか
自分だけが悩んでいる問題ではないはずなので、既存のサービスがどう解いているかを調べた。だいたい 3 つに分かれる。
| 方式 | 例 | crit で使えるか |
|---|---|---|
| コミットごとにインデックスを作っておく | Sourcegraph(SCIP)、GitLab(LSIF)、Google の Kythe | CI にインデクサを組み込む前提。ローカル完結のツールには重い |
| 実体をチェックアウトして本物の Language Server を動かす | Codespaces、VS Code の GitHub Pull Requests 拡張 | 正確に動く。ただし手元の作業ツリーを乗っ取る |
| 仮想ファイルシステム上で動かす | github.dev、vscode.dev | Language Server は実ファイルを要求するので不可 |
sparse checkout した使い捨ての worktree で解決
採用したのは PR の head を、別ディレクトリに detached な git worktree としてチェックアウトし、そこを Language Server のワークスペースにする。ポップアップに表示する内容もそこから読むので、Language Server が返す行番号と表示内容が必ず一致する。
ただ、巨大なリポジトリを丸ごとチェックアウトするのは重い。各言語の Language Server が必要とするのは、 その言語のソースとパッケージマネージャーのメタデータファイルくらいなので、sparse checkout で関係のファイルだけを落とす。
# 例:Go
git worktree add --detach --no-checkout <dir> <HeadSHA>
git -C <dir> sparse-checkout set --no-cone '*.go' 'go.mod' 'go.sum' 'go.work' 'go.work.sum'
git -C <dir> checkout
これらの処理をロジックとして組み込んだ。対象の言語以外のファイルが多いモノレポほどディスク容量の削減が大きい。worktree は LSP を実際に使ったときにだけ作り、gopls がアイドルで止まるときに一緒に消している。
2. Language Server の解析時に、悪意のあるコードを実行してしまう
PR のコードは、他人が書いた信頼できないコードだ。自分のユースケースでは問題ないが、仮にこの Crit を OSS で使う場合に考慮しなければならないトピックである。例えば、メタプログラミングが強力な言語では、静的解析だけでは完全な LSP の機能を提供できないことが多く、解析のためにリポジトリのコードを実行する。VSCode などで、「このワークスペースを信頼しますか?」とダイアログが表示されるのはこのためだ。特に VSCode の標準機能としてサンドボックスなどの機能は提供しておらず、自助努力となる。
Crit では普段自分が描いている Go 以外の言語サポートも検討していたが、調べてみると、レビュー対象のコードを仕様として実行する言語やツールが大半だった。例えば以下。
| 言語 | Language Server | 実行されるもの |
|---|---|---|
| Rust | rust-analyzer | build.rs、proc macro、リポジトリ内の設定に書かれたコマンド |
| Swift | sourcekit-lsp | Package.swift に書いたコード |
| Java / Kotlin | jdt.ls / Kotlin LS | Gradle のビルドスクリプト、Maven プラグイン |
つまり、悪意のある PR を開いてホバーしただけで、手元のマシンで任意のコードが動きうる。
一応手元でも確かめていて、指定したディレクトリにファイルを 1 つ書くだけの無害なビルドスクリプトを仕込んだプロジェクトを用意し、Language Server で開いてホバーを 1 回だけ送る、という実験をした。rust-analyzer は build.rs を実行してファイルを作った。
設定で止められる言語もあるが、そうすると参照検索などの肝心の機能を失う。
実行しないことを保証している言語やツールを優先的に対応
もちろん実行しないツールもある。例えば Python の pyright や Go の gopls など。この問題に取り組んで初めて知ったことなのだけれど、gopls のレビュー対象のコードを実行しない設計は Go の成り立ちから来ている。
- Go の依存関係は
import文で言語仕様として決まる。Gradle やbuild.rsのようなビルド用のプログラムがないので、構造を知るために何かを実行する必要がない #cgoに-fpluginを書くとgo getだけで任意のコードが動く脆弱性(CVE-2018-6574)が見つかった。Russ Cox は golang/go#23672 で「Go get downloads and builds source code. It is not meant to execute arbitrary code.」と書き、cgo のフラグを許可リスト方式にした- この考え方は、いまは公式のセキュリティ方針になっている。Go Security Policy Decisions は「Building an attacker-controlled program should be safe, even when running it is not.」と書き、悪意あるモジュールが
go buildで任意コードを実行できることを脆弱性として扱うと明記している
gopls はビルドシステムを独自に解釈せず、go list を経由してパッケージを読む。なので、この go コマンドの保証をそのまま引き継いでいる。それでも実装のバグでリスクは残るのだけれど、この仕様のおかげで Go の LSP 対応をシュッと対応できた。
解析のためにソースコードを実行する言語やツールの恒久対応としては、macOS Seatbelt などの軽量な OS サンドボックスを使うことを考えている。
3. Reference (参照ジャンプ) のメモリ利用が多い
k8s 規模(約 3,000 パッケージ)のリポジトリで gopls を動かすと、メモリが 8〜9 GB まで膨らむ。特に三章ジャンプを提供する Reference では、同時に Crit を並列で動かすとその分圧迫してしまうので、最悪の場合 OOM に繋がってしまう。 この課題についてはちゃんとした解が出せていない。
VSCode などで、ファイルを削除するときに言語拡張機能のローディングでもたつくことがあるのは大抵メモリ圧迫であることが多い。 あとは GC 。K8s の例では、中身を調べてみると、gopls が実際に使っているヒープは、ピークで約 5.3 GB、読み込みが終わると約 0.9 GB まで下がる。残りはまだ回収されていないゴミだった。エディタではなく、Crit のような短命の起動を主とする使い方では GC が走るまえに Language Server がシャットダウンされることも多いので
この問題の解決策としては、directoryFilters で読み込むディレクトリを絞ったり、一度インデックス化するなどの方法が取られているようだ。https://github.com/sivchari/golance もその流れだろう。ただし、ディレクトリを絞る方法では参照ジャンプの結果が欠けてしまうので、レビューツールである Crit ではそのままでは採用できない。
おわりに
現状の取り組みを書いてみた。絶賛開発中なので、ここで挙げたトピックに対する解決法のアイデアがあれば https://github.com/sho-hata/crit の issue や pr にて。